Qt 如何解决 Emoji 表情符号编译失败的问题
Posted on Wed, 24 Dec 2025 10:38:14 +0800 by LiangMingJian
问题
在 Windows 系统上使用 Python 编写 Qt 程序时,一般的步骤都是先通过 QtDesigner 设计好界面,然后再通过 pyside6-uic.exe 或者 QtDesigner 自带的 View Python Code 工具,将 QtDesigner 生成的 .ui 文件转换为 .py 文件。
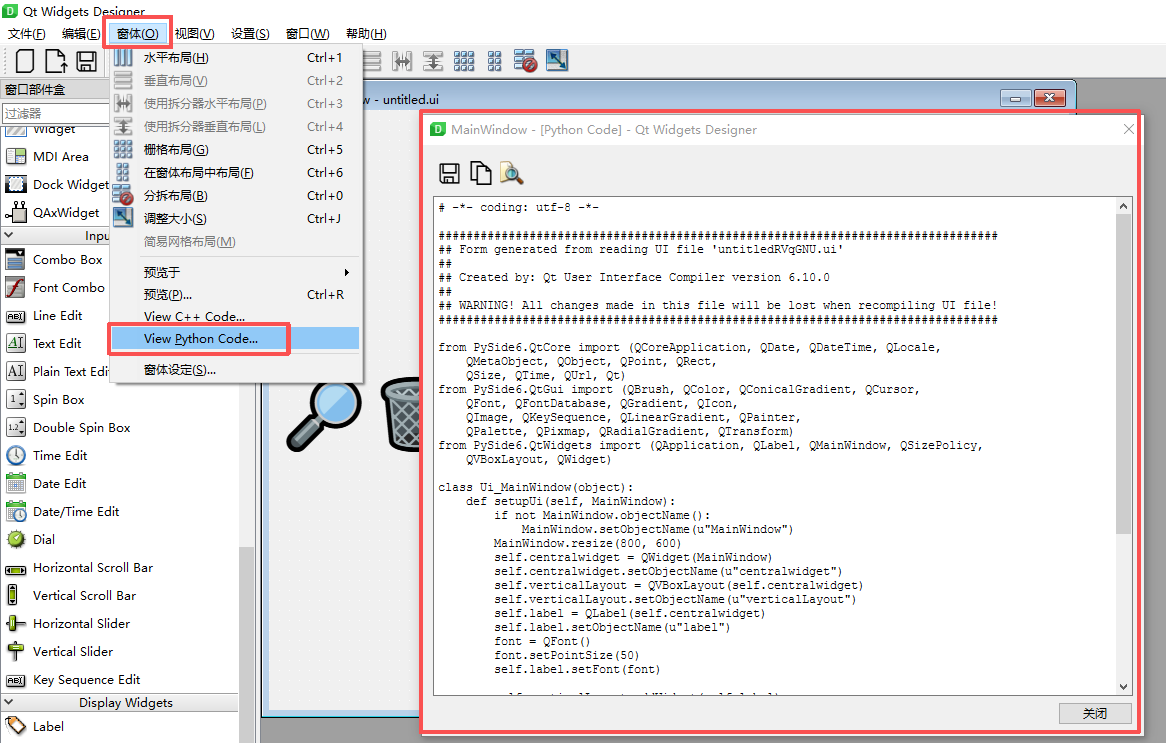
在这个转换过程中,对于一般的文字或符号,都不会出现异常。但是,如果 UI 界面中存在类似下面的这些 Emoji 表情,那么转换后的 .py 文件在使用会出现编码错误的异常。
Emoji 表情是一种文本类型的特殊符号,它可以和文字一样直接使用,原产于日本,是在无线通信中使用的视觉情感符号。在 Windows 系统中,通过按下快捷键
Win+.可以快速的调起 Emoji 工具界面,输入所需的 Emoji 表情。或者,通过访问 Emojiall 这个 Emoji 表情网站,复制表情符号然后使用。
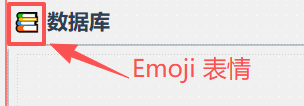
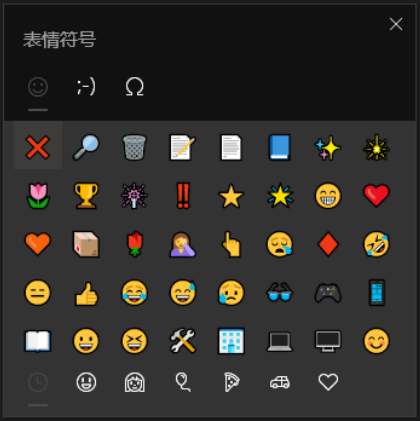
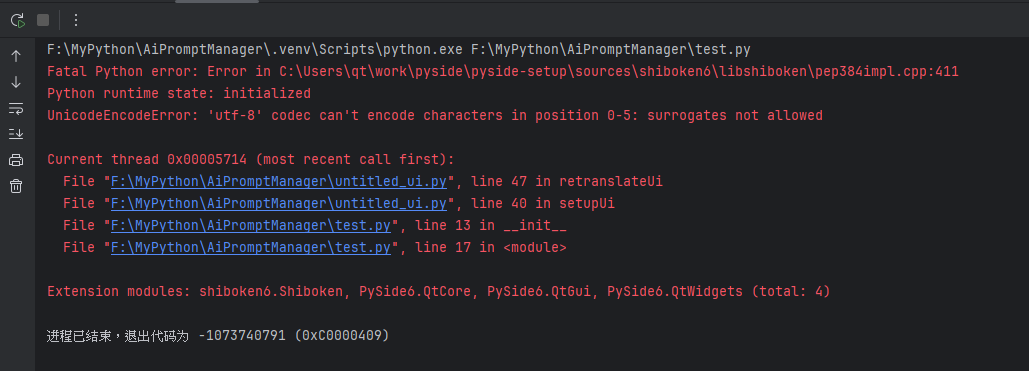
在 Windows 系统上,如果使用工具将带有 Emoji 表情的 UI 文件转换为代码,这个代码在调用运行时,会出现如下的报错:
UnicodeEncodeError: 'utf-8' codec can't encode characters in position 0-5: surrogates not allowed
问题分析
正如报错提示所言 'utf-8' codec can't encode characters,无法使用 UTF-8 对代码进行解码。这里我们应该想到,应该是 Emoji 表情编码的问题(正常没带 Emoji 表情时候,代码是正常运行的)。因此,我们可以去检查生成代码中的对应编码是否正常。
对于 UI 文件中 <string>🔎🗑📘⭐🌹👆♦</string> 的 Emoji,在使用工具转换后,其代码被识别为 QCoreApplication.translate("MainWindow", u"\ud83d\udd0e\ud83d\uddd1\ud83d\udcd8\u2b50\ud83c\udf39\ud83d\udc46\u2666", None),显然这个代码明显的不正确,我们通过 \ud83d 到对应的网站查询其 UTF-8 对应字符内容,可以发现其不是我们所需的 Emoji。
为什么会出现这个问题?因为 Windows 系统是中文环境时,其编码默认是 GBK,而不是 UTF-8!
正是因为编码环境的不同,导致在对 Emoji 进行编码时,错误的使用 GBK 编码,从而导致在运行时无法使用 UTF-8 解码。
问题解决
既然知道问题出在哪里,那解决也有方法了。既然是编码环境的不同,那我们只要将编码环境变回 UTF-8 即可。
在执行 UI 文件转换前,执行命令 chcp 65001,将编码环境变更为 UTF-8,然后再执行 UI 文件转换,此时代码便会恢复正常。
特别注意,一般只建议通过 chcp 命令临时修改编码,不建议直接修改全局编码,因为系统有些东西可能是默认使用 GBK 编码的。
chcp 65001
pyside6-uic.exe untitled.ui -o untitled_ui.py